モデルの生成例
このページのモデルによる実際の出力を、それを生んだプロンプトとあわせて掲載しています。プロンプトをコピーするか、モデルを開いて自分で実行できます。
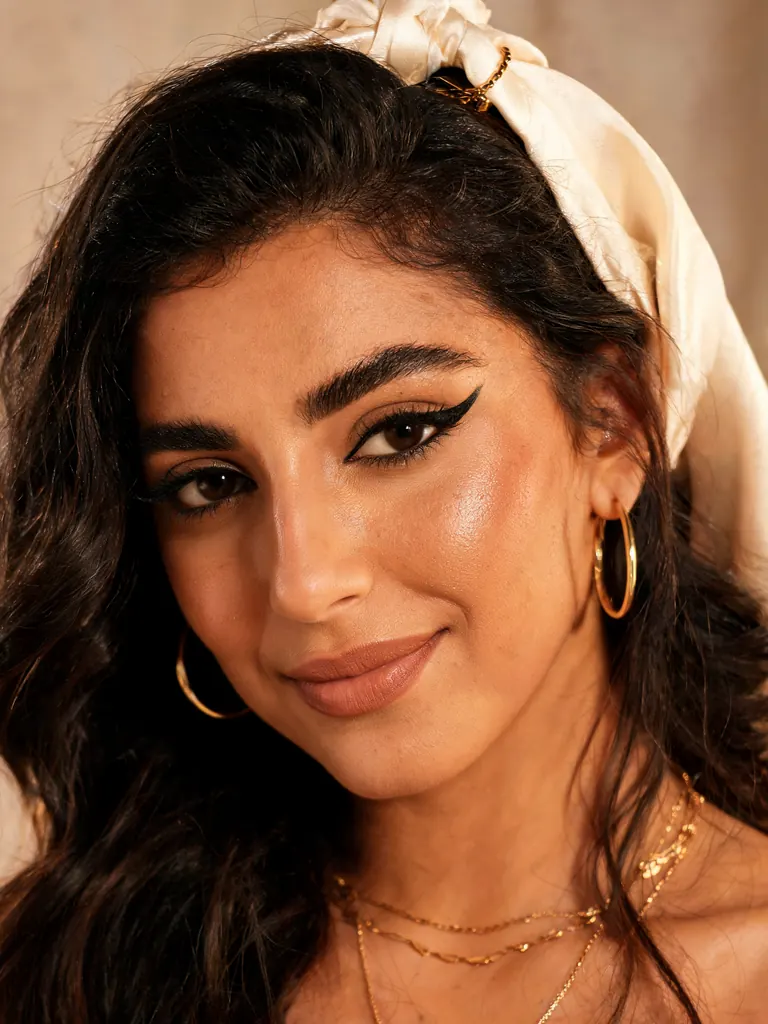 編集前
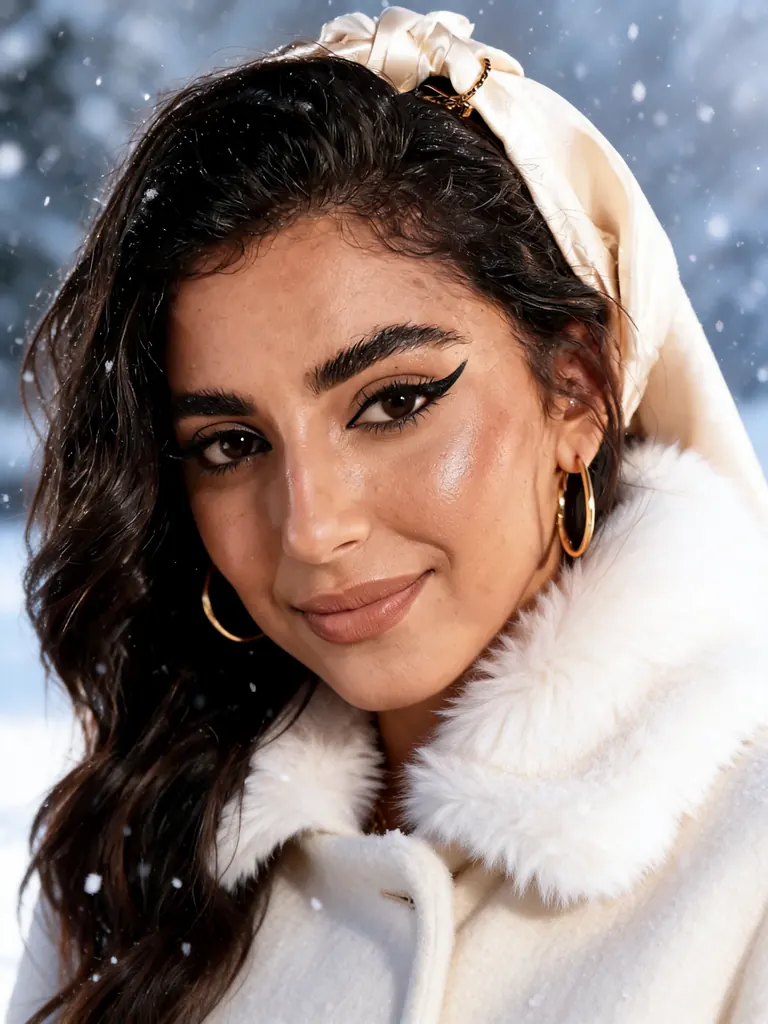 編集後
Make it a snowy winter scene: add a cream wool coat with a fur collar and softly falling snow; keep her face, makeup and pose
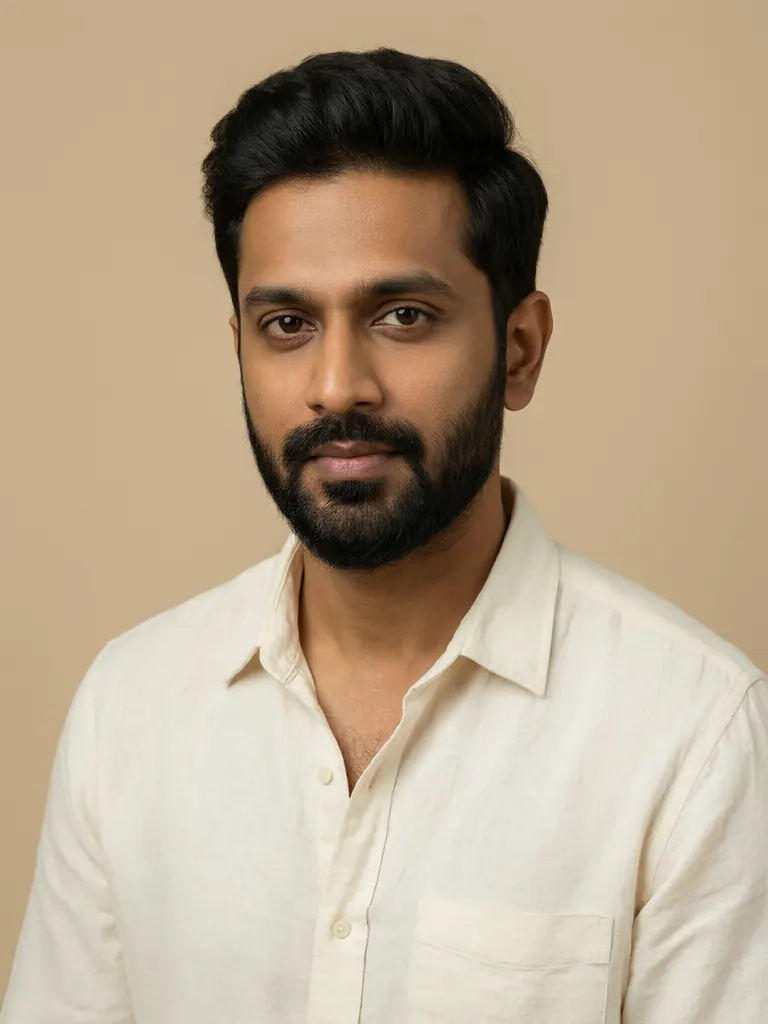 編集前
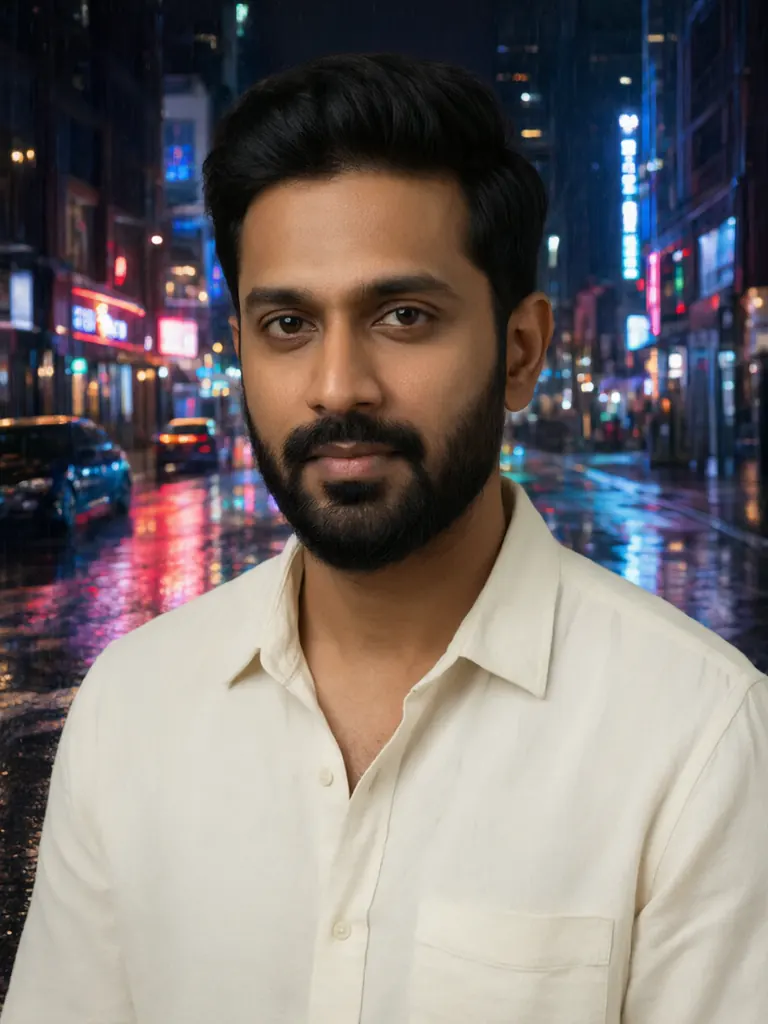 編集後
Replace the background with a rainy neon-lit city street at night with reflections on the wet pavement; keep the man, his pose and his clothing exactly the same
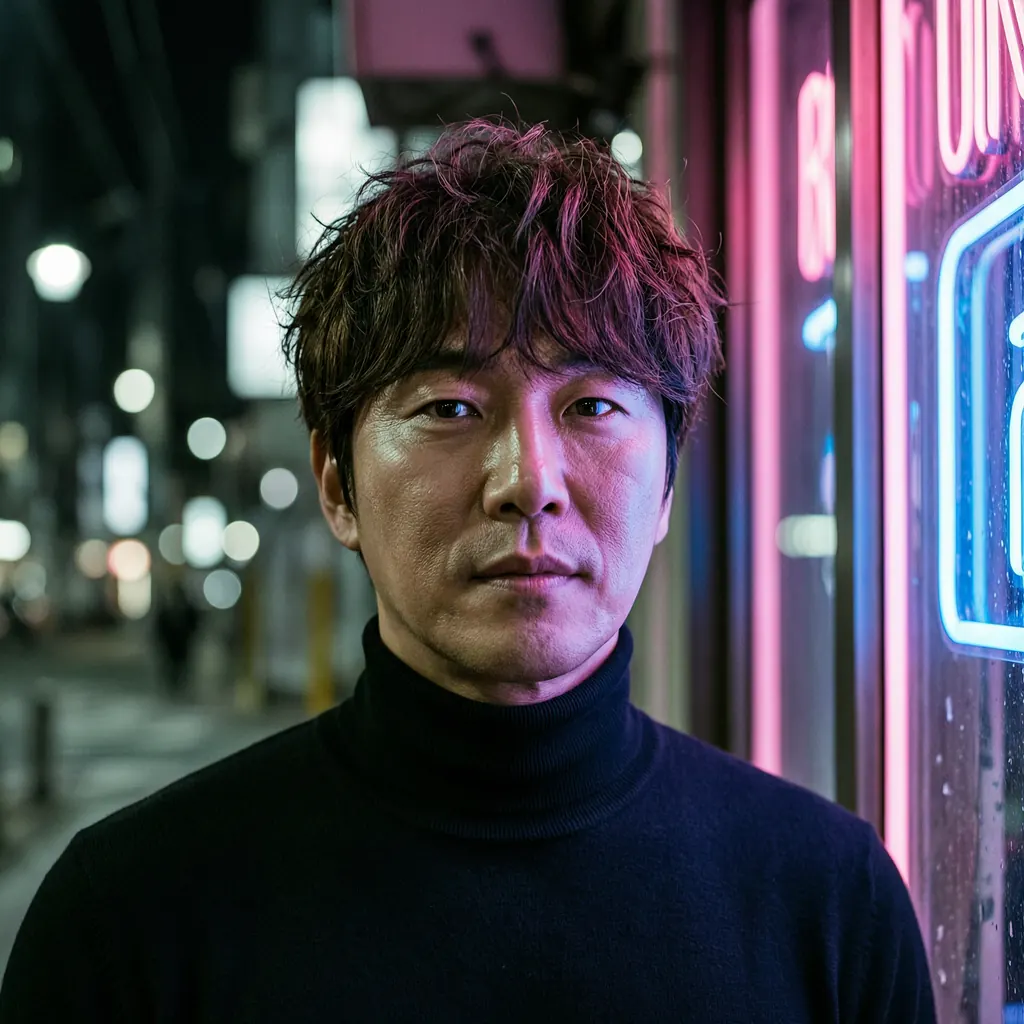 編集前
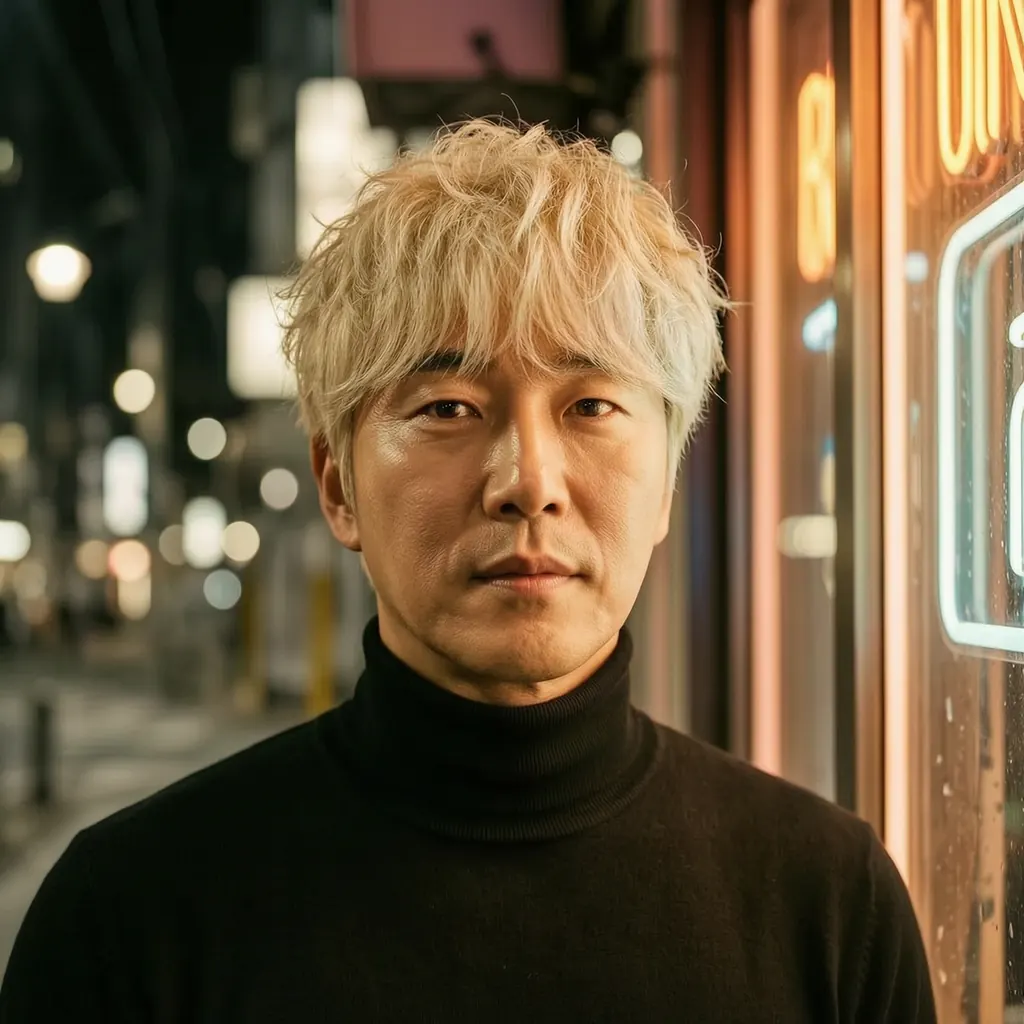 編集後
Change his hair to platinum blond and the lighting to warm golden-hour sunlight; keep everything else the same
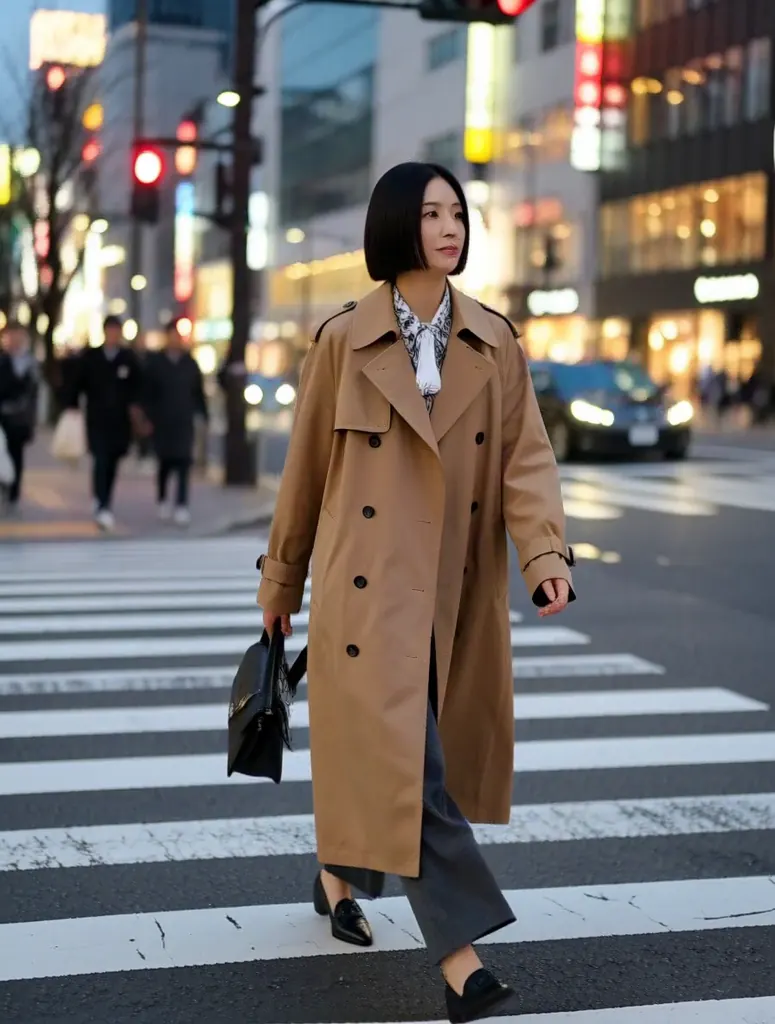 編集前
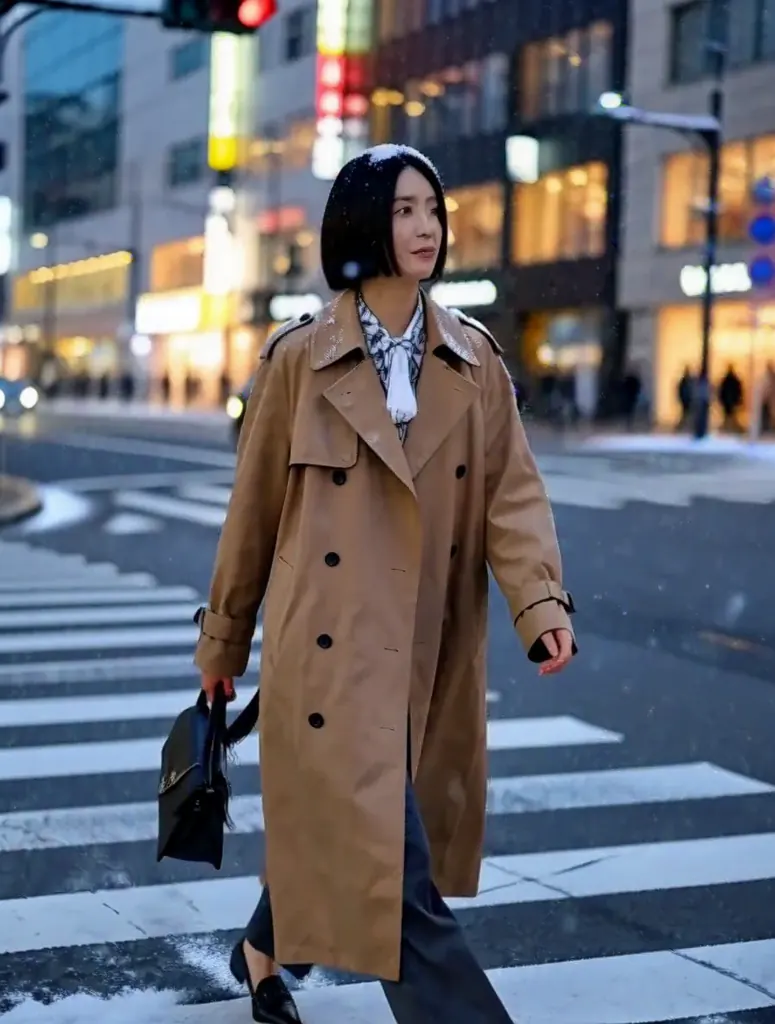 編集後
Change the scene to a snowy winter night: deep blue evening sky, heavy snow falling and settling on the street and on her coat, warm shop windows glowing behind her; keep the woman unchanged
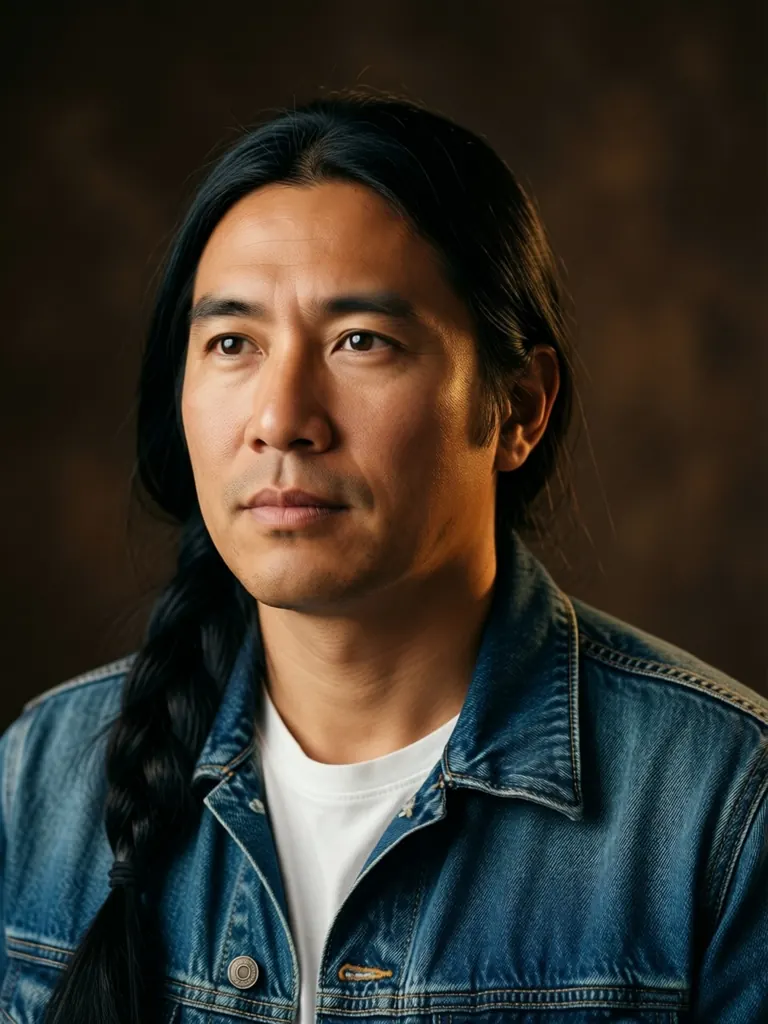 編集前
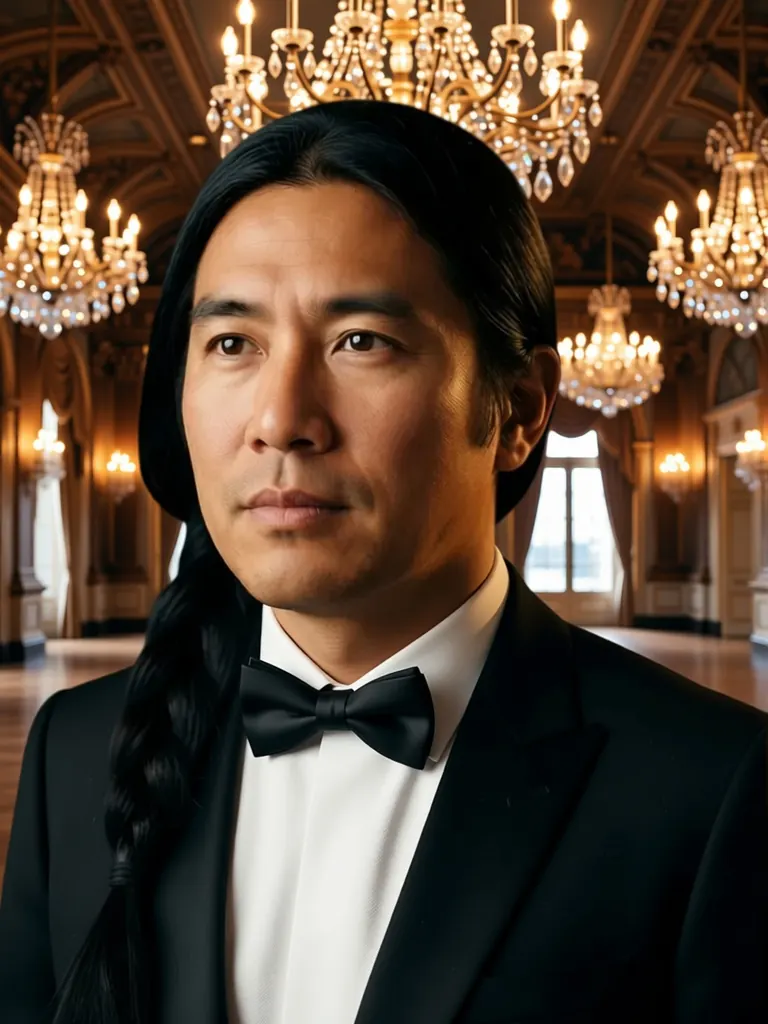 編集後
Change his denim jacket to a black tuxedo with a bow tie and replace the backdrop with a grand ballroom lit by crystal chandeliers; keep his face, hair and pose unchanged
アンカーは文章ではなく画像
同一性を固定するのは、よりよい文ではなく添付です。IP-Adapterの論文でYe et al.は理由を率直に書いています。テキストだけで狙いどおりの画像を得るのは難しく、「it often involves complex prompt engineering」(複雑なプロンプトエンジニアリングを伴うことが多い)からです。特定のあごの形を表す形容詞はなく、いくつ重ねても一つにはなりません。ここでは画像モデルがすべて参照画像を受け付けます。最も多くの参照を読むのはSeedream 5 Liteで、顔、服装、部屋を別々の画像で渡したいときに役立ちます。添付の方法は規制なしのAI画像編集のページにあります。
どんな画像でもアンカーになるわけではありません。ドラマチックなフレームより、平坦で均一な光のポートレートのほうがたいてい有利です。意図せずコピーされる要素が少ないからです。強いリムライトや色かぶりも手がかりとして読まれ、顔だけのつもりだったことをモデルが知る方法はありません。アンカーは地味にして、演出はプロンプトに任せましょう。
画像は手がかりではなくフレームとして渡すこともでき、そうすると役割もルールも変わります。違いと、それに伴うトリミングは静止画から動画へで扱っています。
機能は推測ではなく宣言で決まる
カタログのモデルはすべて、何ができるかを公開しています。画像か動画か、そしてテキストモードと参照モードそれぞれのサイズと料金です。画像を添付すると同じモデルIDが参照モードで動くので、モデルページ、カタログのエンドポイント、サーバーの三者が、リクエスト本文の形について一致します。
参照を読むモデルは自分の最小枚数と最大枚数を宣言しており、拒否は両方向に働きます。参照前提のモデルは、参照のないリクエストを断ります。参照を読まないモデルは、添付を捨てて描画するのではなく、添付のあるリクエストを断ります。お金を守るのは後者です。画像が捨てられると、画像を一度も使っていない出力と、それを知らせない画面だけが残るからです。
有効なサイズもモデルごとに決まっていて、名前の似た兄弟モデルから受け継ぐものではありません。添付には追加料金がかかる場合があり、合計は生成ボタンでも解像度と長さの選び方でも確認できます。
一度作り、残し、戻す
最初は描写だけで動くモデルから始めます。この段階ではキャラクターはまだ決まっておらず、守るためではなく、誰なのかを見つけるためにお金を使います。一枚が決まるまで言葉を調整しましょう。そこまでの道のり自体が一つの技術で、それを通しで扱うのがオリジナルキャラクターのデザインです。イラストやオリジナルキャラクターなら、最初の一枚は人物やキャラクター向けのAIアートの流れで描き、そこから先をこのガイドで扱います。hentaiやアニメ調のキャラクターも同じアンカーの習慣に従い、線画や塗りの書き方はAIエロアニメ・hentai生成で扱っています。
次に、決まった一枚を実際にダウンロードして保存します。何か月も使うアンカーは、自分で管理できる場所に置きましょう。
戻すときはリンクのコピーでは足りません。完成した生成結果は認証の内側で配信されており、描画を担う生成サービスは本人としてログインできないので、ファイルをアップロードし、返ってきたURLで添付する必要があります。エンドポイントと拒否条件は静止画から動画へにあります。画面上ではモデルページの参照画像欄がこれを代行します。アンカーを受け付ける編集モデルの一部は、それぞれが受け付けるものとあわせて一ページにまとめてあり、残りはカタログ全体にあります。
以降のショットは、場面だけを変えた一回のリクエストです。同じ添付、同じキャラクターの言葉で、書き換えるのは演出だけ。リクエスト本文はAPIリファレンスに、フレームの他の部分が一緒に動かないようにする言葉の規律はフィルターなしのプロンプトの書き方にあります。
同一性がずれる場所と、変えるべきこと
ここでの再現性は、書き留められる数値ではなく添付から生まれます。シード値を提供するモデルでも実行ごとにフレームはずれ、大半のモデルにはシード値そのものがありません。仕組みは解像度と長さの選び方にあります。同じ内容を二回送れば独立した二回の抽選になるので、描写だけでつないだシリーズは構造上ずれていきます。
最も多い原因は、テイクの合間にプロンプトを書き換えることです。言い換えるたびに、顔も含めて、触れるつもりのなかった部分まで決め直しになります。一度に一節ずつ動かせば、何が一緒に動いたかが見えます。
二つ目は、新しい出力を毎回アンカーに格上げすることです。生成は入力をコピーするのではなく描き直すので、アンカーのアンカーのアンカーは出発点から着実に離れていきます。アンカーはセットで持ちましょう。最初の一枚はすべてのリクエストに残し、よい新しいフレームはそれと入れ替えずに加えます。これが難しいのは気のせいではありません。Avrahami et al.は「The Chosen One: Consistent Characters in Text-to-Image Diffusion Models」の冒頭で、「the users that use these models struggle with the generation of consistent characters」(利用者は一貫したキャラクターの生成に苦労している)と指摘しています。
三つ目は、ずれる部分がアンカーに写っていないことです。斜め前からのポートレートは、背中側にしか見えないバックルについて何も伝えないので、モデルは毎回それを作り直します。説明する文ではなく、それが見える角度の画像を加えましょう。
自分がしていないことを知るのも役に立ちます。DreamBooth(Ruiz et al., CVPR 2023)は「just a few images of a subject」(被写体の数枚の画像)からモデルを微調整し、モデルが「learns to bind a unique identifier with that specific subject」(固有の識別子をその被写体に結びつけることを学ぶ)ようにします。ここには学習の段階がないので、同一性はリクエストのたびに画像から導き直されます。ずれることがあるのはそのためで、再学習なしに二つのショットのあいだでキャラクターを替えられるのもそのためです。
キャラクターを動画に持ち込む
動画では分かれ方が違います。画像を受け取る動画モデルは渡した画像から始まるので、作ったフレームがそのまま動き出します。構図はすでに決まっていて、トリミングはモデルではなく自分が決めることになります。動画側にはキャラクターを中心にショットを組み立てる仕組みがないので、誰が映るかは画像の段階で決めておく必要があります。Vellriaで試した範囲では、Seedance 2.5は渡したフレームを最も忠実に保ったモデルの一つでした。この流れの成人向け版はNSFW画像から動画で扱っています。
順序はそこから決まります。画像モデルでアンカーを作り、狙うフレームを静止画として演出し、静止画を動画モデルに渡し、キャラクターの言葉は変えずに動作だけを変えます。流れの全体は規制なしのAI動画生成のページに、一つの作品として読まれる必要がある一連のショットは絵コンテとプリビズにあります。