O que os modelos geram
Resultados reais dos modelos desta página, cada um com o prompt exato que o gerou. Copie um prompt ou abra o modelo e rode você mesmo.
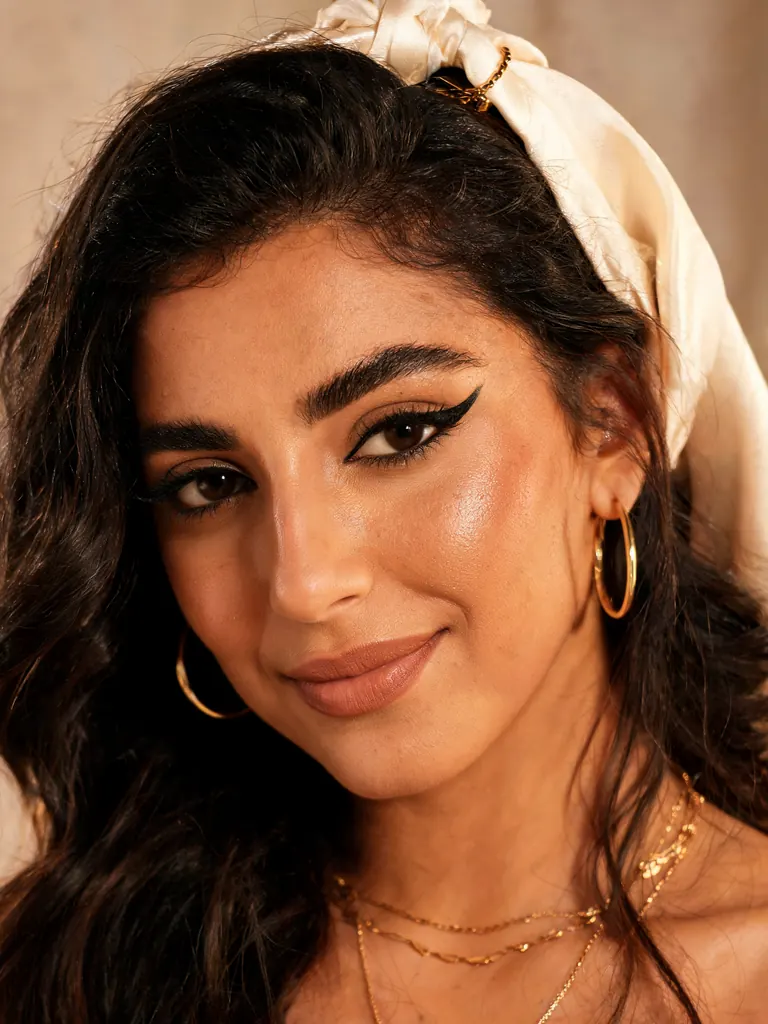 Antes
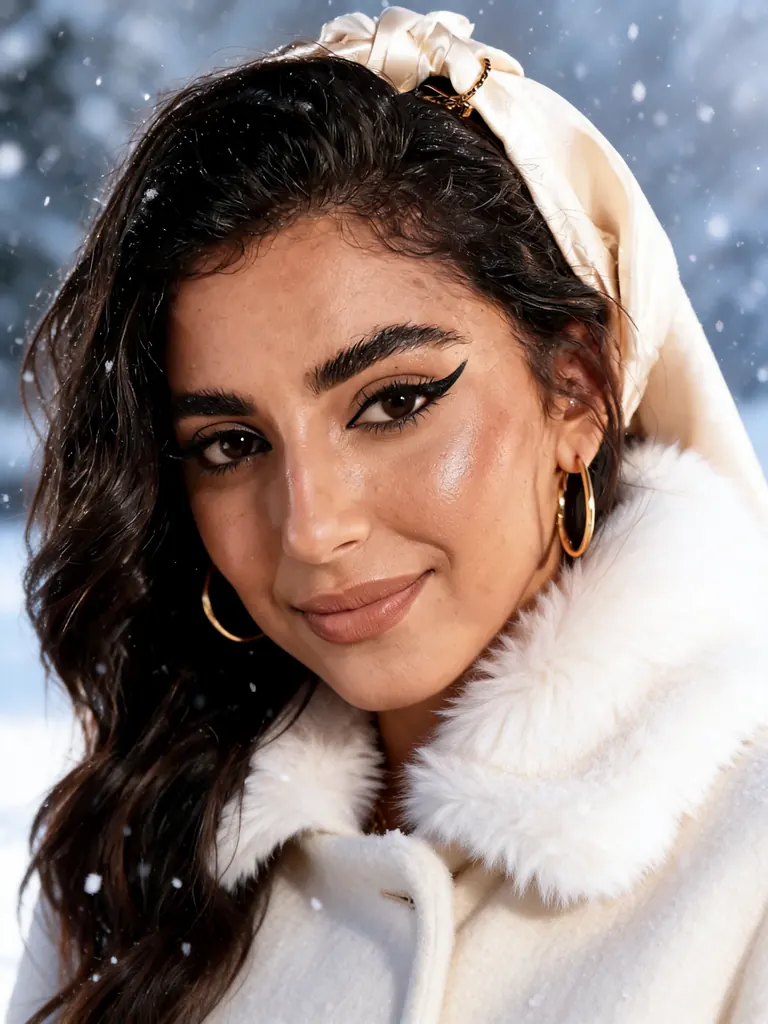 Depois
Seedream 5 Lite Sem censuraEdição
Make it a snowy winter scene: add a cream wool coat with a fur collar and softly falling snow; keep her face, makeup and pose
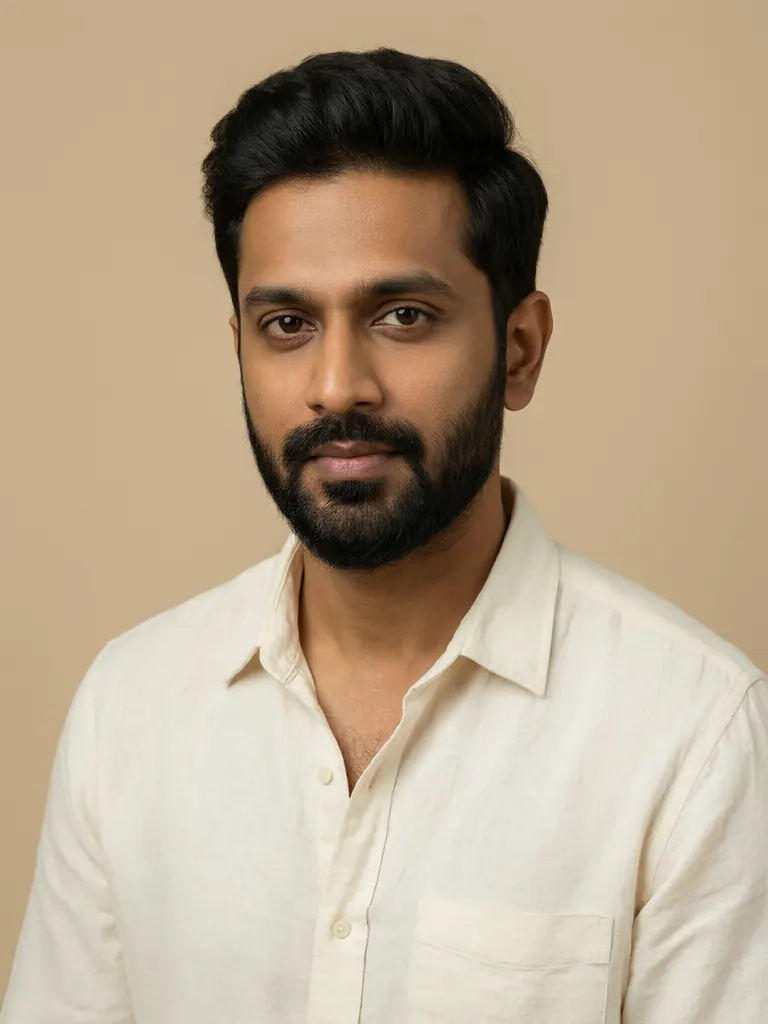 Antes
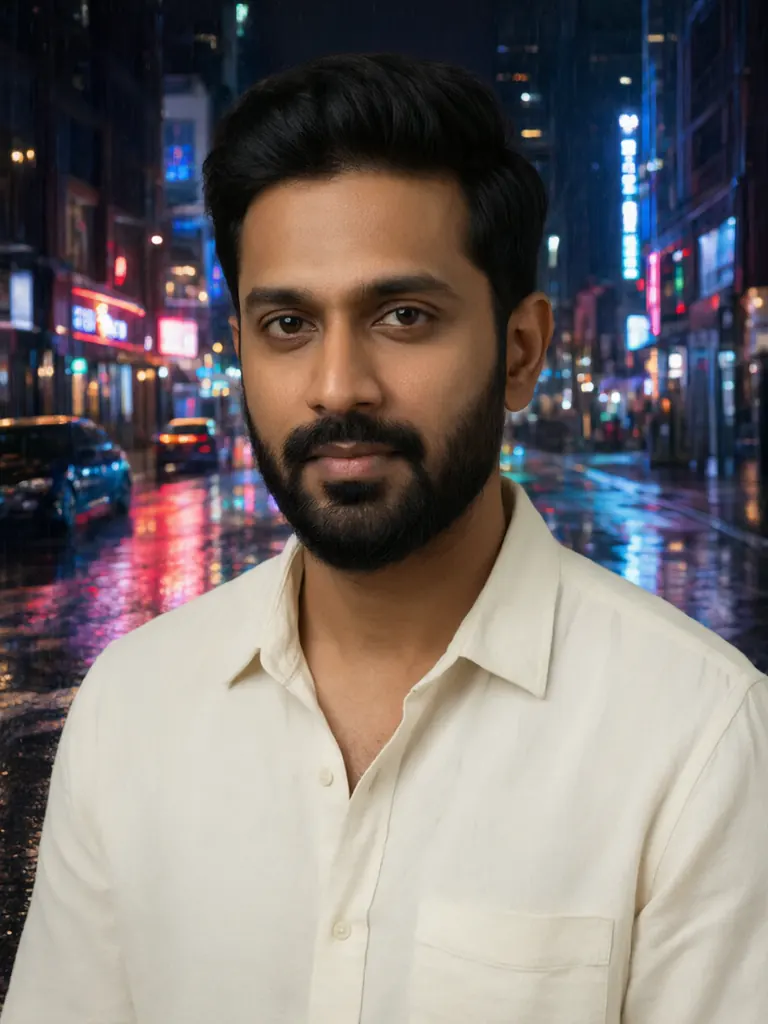 Depois
Qwen 3 Sem censuraEdição
Replace the background with a rainy neon-lit city street at night with reflections on the wet pavement; keep the man, his pose and his clothing exactly the same
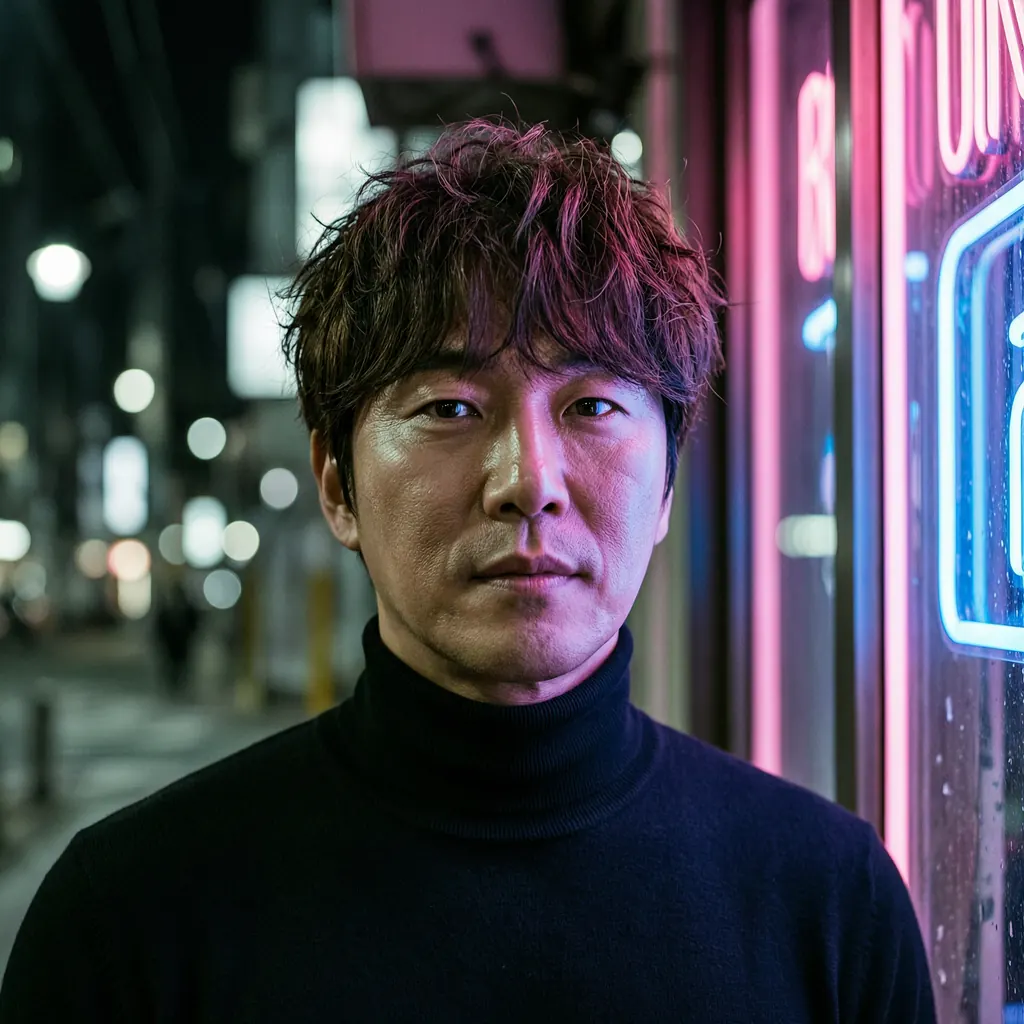 Antes
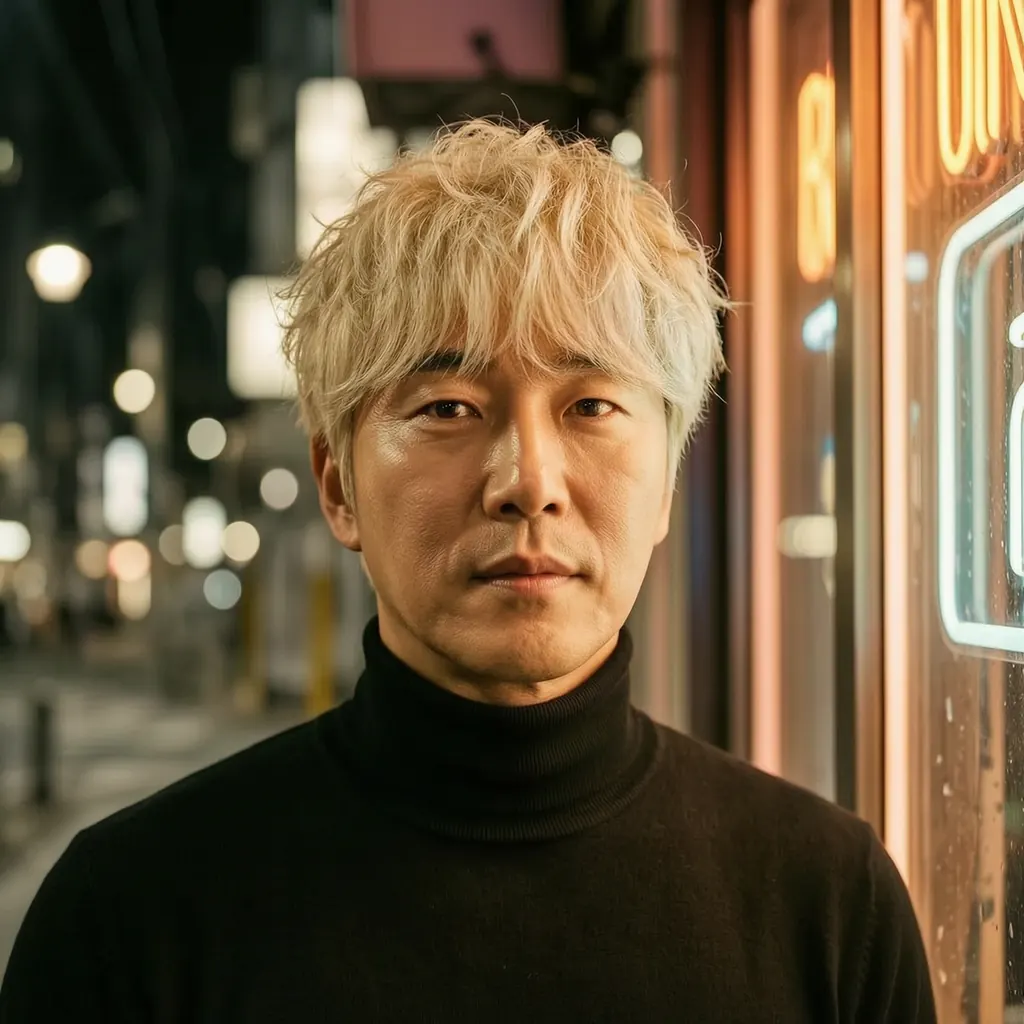 Depois
Wan 2.7 Sem censuraEdição
Change his hair to platinum blond and the lighting to warm golden-hour sunlight; keep everything else the same
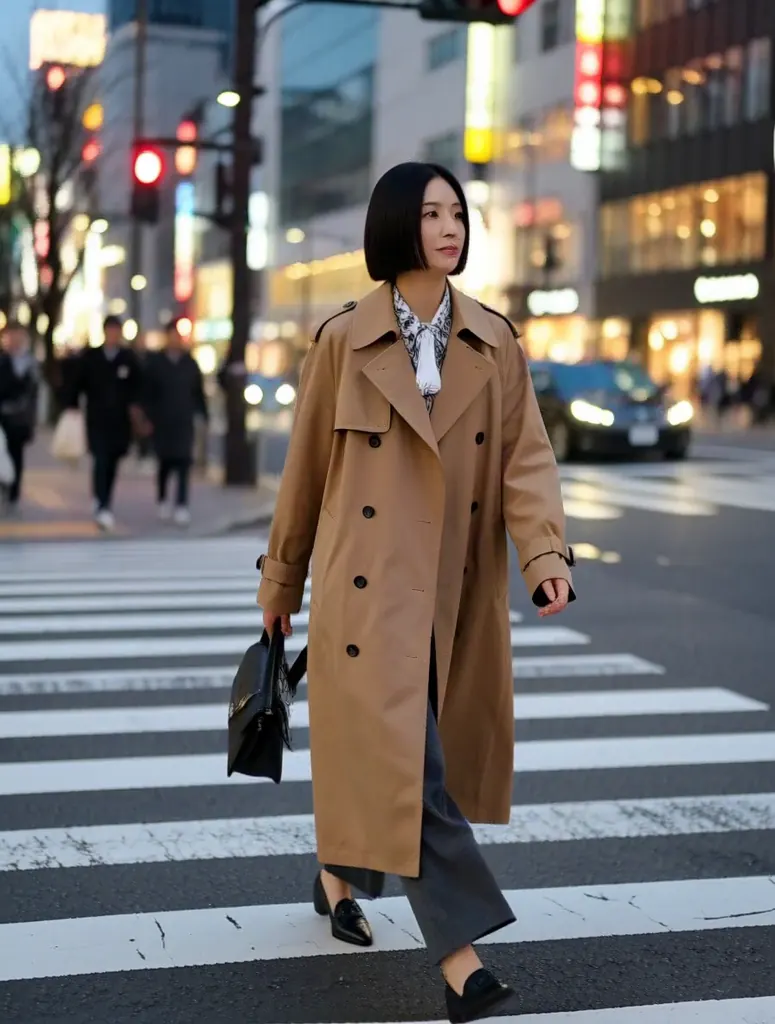 Antes
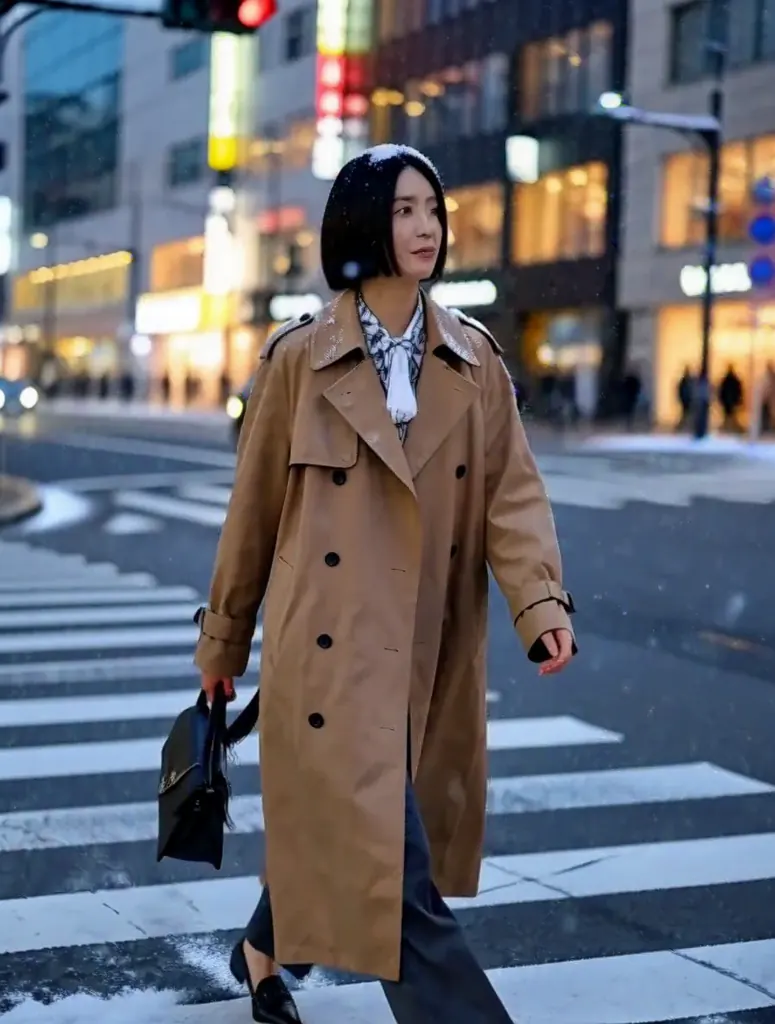 Depois
MiniMax H3 Image Sem censuraEdição
Change the scene to a snowy winter night: deep blue evening sky, heavy snow falling and settling on the street and on her coat, warm shop windows glowing behind her; keep the woman unchanged
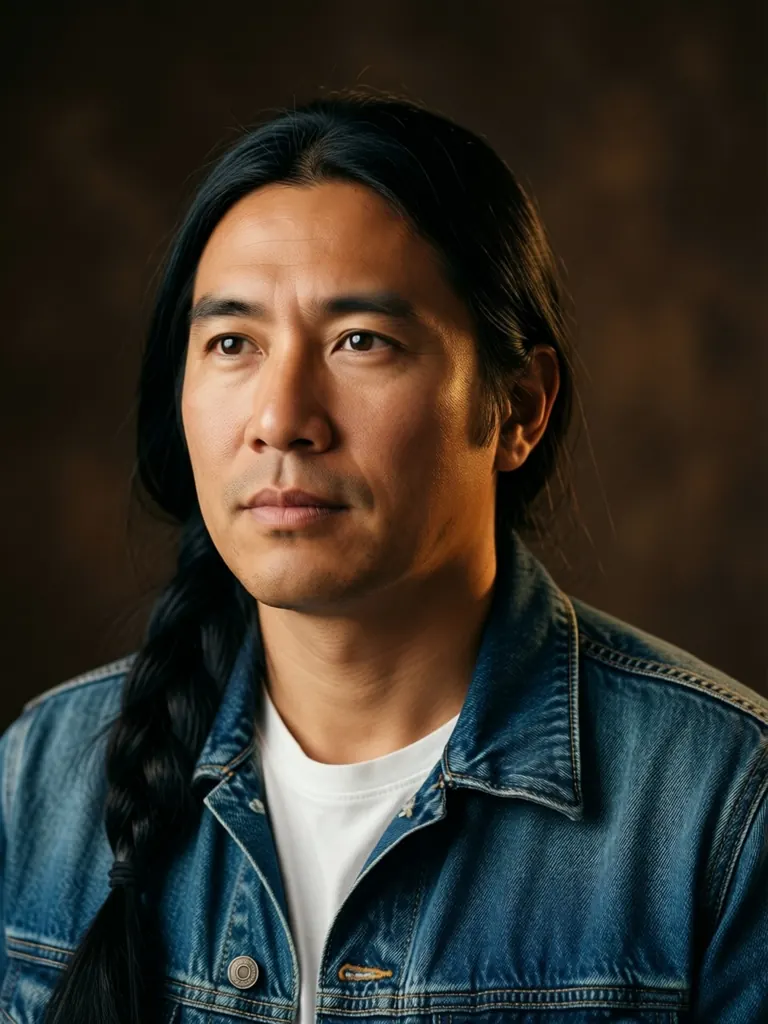 Antes
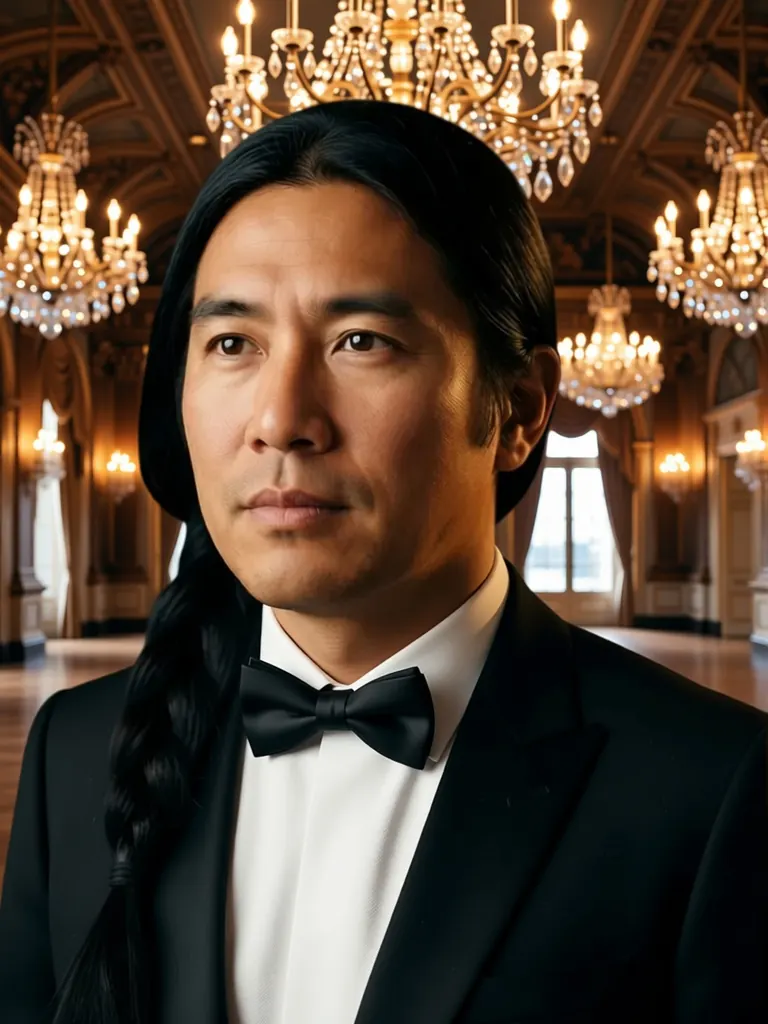 Depois
Qwen Image Edit 2511 Sem censuraEdição
Change his denim jacket to a black tuxedo with a bow tie and replace the backdrop with a grand ballroom lit by crystal chandeliers; keep his face, hair and pose unchanged
Uma âncora é uma imagem, não um parágrafo
O que segura uma identidade no lugar é um anexo, não uma frase melhor. Ye et al., no artigo do IP-Adapter, dão o motivo com clareza: tirar só do texto a imagem que você quer é complicado porque “it often involves complex prompt engineering”. Não existe adjetivo para um maxilar específico, e nenhuma quantidade deles chega a formar um. Todo modelo de imagem aqui aceita uma referência; o Seedream 5 Lite lê o maior conjunto delas, o que ajuda quando uma imagem carrega o rosto e outras a roupa e o ambiente, e a página do editor de imagem IA NSFW explica como as referências são anexadas.
Nem toda imagem serve de âncora. Um retrato simples, com luz uniforme, costuma funcionar melhor do que um quadro dramático, porque há menos nele para ser copiado por acidente: uma luz de recorte forte ou uma dominante de cor também contam como evidência, e o modelo não tem como saber que você queria só o rosto. Deixe a âncora sem graça e passe a encenação para o prompt.
Uma imagem também pode chegar como quadro de abertura, e não como evidência, o que é outro trabalho, com outras regras; converter imagem em vídeo explica essa divisão e o recorte que ela obriga você a fazer.
A capacidade é declarada, não deduzida
Cada modelo do catálogo publica o que faz: imagem ou vídeo, junto com os tamanhos e preços do modo texto e do modo referência. Anexe imagens e o mesmo id de modelo passa ao modo referência, então a página do modelo, o endpoint do catálogo e o servidor concordam sobre a forma que o corpo de uma requisição deve ter.
Modelos que leem referências declaram seu próprio mínimo e máximo, e as recusas valem nos dois sentidos. Um modelo construído em torno de referências recusa uma requisição que chega sem nenhuma. Um que não lê nenhuma recusa uma requisição que as traz, em vez de descartar o anexo e renderizar assim mesmo. É a segunda recusa que poupa seu dinheiro, porque uma imagem descartada deixa você com um resultado feito sem ela, e nada na tela avisa.
Os tamanhos válidos também pertencem ao modelo e não são herdados de um parente de nome parecido. Anexos podem ter custo adicional, e tanto o botão de gerar quanto escolher resolução e duração fazem essa soma por você.
Rascunhe uma vez, fique com o melhor quadro e devolva-o
Comece em um modelo que trabalha só com descrição, enquanto o personagem ainda está em aberto e você paga para descobrir quem ele é, não para proteger ninguém. Ajuste a redação até um quadro ficar certo; chegar lá é um ofício à parte, e criar um personagem original cobre esse ofício do começo ao fim. Para um personagem ilustrado ou original, o fluxo de arte IA para figuras e personagens é onde esse primeiro quadro é desenhado; este guia trata do que fazer com ele depois. Um personagem com visual de hentai ou anime segue o mesmo hábito de âncora, mais a regra que o gerador de hentai IA impõe a todo personagem desse tipo: adulto em todos os quadros.
Depois, fique com ele de fato, baixando o arquivo, para que uma âncora que você pretende reutilizar por meses more em um lugar que você controla.
Devolver a âncora não é questão de copiar o link. Uma geração pronta só pode ser acessada com suas credenciais, e o provedor que faz a renderização não tem como entrar como você; por isso o arquivo precisa ser enviado e anexado pelo endereço que volta. Converter imagem em vídeo traz o endpoint e as recusas. Na interface, a caixa de referência faz isso por você, e uma seleção dos modelos de edição que aceitam uma âncora está reunida em uma página, com o que cada um aceita; o catálogo completo tem o restante.
Cada tomada seguinte vira então uma requisição com outra cena: o mesmo anexo, a mesma descrição do personagem, só a encenação reescrita. A referência da API mostra o corpo da requisição, e escrever prompts sem filtro traz a disciplina de redação que impede o resto do quadro de se mexer junto.
Onde a identidade desvia e o que mudar
Aqui a reprodutibilidade vem do anexo, não de um número que você possa anotar: uma seed, nos modelos que a oferecem, ainda deixa o quadro variar entre execuções, e a maioria dos modelos não oferece seed nenhuma; escolher resolução e duração mostra esse mecanismo. Dois envios idênticos são dois sorteios independentes, então uma série sustentada só por descrição desvia por construção.
Reescrever o prompt entre as tomadas é a causa mais comum. Cada descrição refeita reabre a negociação sobre tudo o que você não queria tocar, inclusive o rosto. Mexa em uma oração por vez e você verá o que se mexeu junto com ela.
Promover cada novo resultado a âncora é a segunda causa. Uma geração reinterpreta suas entradas em vez de copiá-las, então uma âncora feita a partir de outra âncora, que por sua vez veio de outra, se afasta aos poucos do ponto de partida. Mantenha um conjunto de âncoras: o quadro original fica em todas as requisições, e bons quadros novos entram no conjunto em vez de aposentá-lo. A dificuldade não é impressão sua. Avrahami et al., em “The Chosen One: Consistent Characters in Text-to-Image Diffusion Models”, abrem o artigo observando que “the users that use these models struggle with the generation of consistent characters”.
A terceira causa é uma âncora que não mostra a parte que desvia. Um retrato de três quartos não diz nada sobre uma fivela que só aparece de costas, então o modelo a reinventa toda vez. Acrescente uma vista que a mostre, e não uma frase que a descreva.
Ajuda saber o que você não está fazendo. O DreamBooth (Ruiz et al., CVPR 2023) parte de “just a few images of a subject” e ajusta o modelo para que ele “learns to bind a unique identifier with that specific subject”. Aqui não há etapa de treino, então a identidade é recalculada a partir das suas imagens a cada requisição. É por isso que ela pode escorregar, e também por isso que você pode trocar de personagem entre duas tomadas sem retreinar nada.
Levando o personagem para o vídeo
No vídeo, a divisão é outra. Um modelo de vídeo que recebe uma imagem abre nela, então o quadro que você fez é o que ganha movimento: a composição sai de discussão e o recorte vira decisão sua, não do modelo. Nada do lado do vídeo compõe uma cena em torno de um personagem por você, então quem aparece precisa estar resolvido enquanto o trabalho ainda é uma imagem. O Seedance 2.5 esteve entre os modelos que mantiveram um quadro recebido com mais fidelidade nas nossas execuções, e a página de imagem para vídeo IA NSFW cobre a versão adulta desse caminho.
A ordem decorre disso: construa a âncora em um modelo de imagem, monte como imagem estática o quadro que você quer, entregue essa imagem ao vídeo e mantenha a descrição do personagem idêntica para que só a ação mude. A página do gerador de vídeo IA sem censura mostra os caminhos, e storyboard e pré-visualização trata de uma sequência de tomadas que precisa parecer uma produção só.